








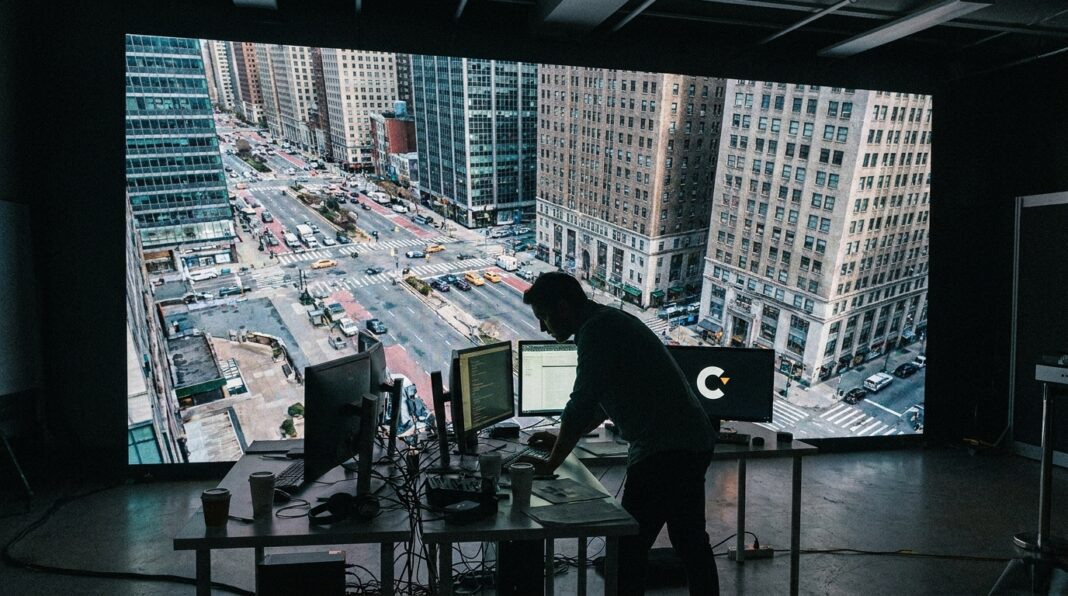

GPT-6 Astra nerfed después del lanzamiento es la percepción reportada por usuarios y testers que dicen que el modelo parece haber disminuido su inteligencia en comparación con su rendimiento inicial, con comparaciones directas en pruebas mostrando resultados peores. Algunos testers observaron respuestas más rápidas pero respuestas de menor calidad y sospecharon de un valor de utilidad reducido. Una semana después del lanzamiento, GPT-6 Astra estaba reconstruyendo Manhattan calle por calle dentro de un motor de juego.
Múltiples usuarios y testers informaron que GPT-6 Astra parece funcionar peor ahora que al lanzamiento, describiendo el modelo como significativamente más tonto en comparaciones directas. Los testers informaron que, aunque algunas respuestas se producen más rápido en la versión actual que al lanzamiento, la evaluación cualitativa de esas respuestas es peor. Varios testers expresaron la sospecha de que el «valor de utilidad» del modelo—un término abreviado para la cantidad de esfuerzo computacional que el modelo gasta pensando antes de responder—había sido reducido.
En comparaciones de prompts controlados, Salio y Md Ismail Sojal ejecutaron los mismos prompts en una instancia del día del lanzamiento de Astra y en una versión posterior, y registraron resultados peores en la versión posterior. Estos informes de usuarios y observaciones de testers se centraron en la calidad de salida comparativa y el tiempo de respuesta sin especificar cambios internos.
Los informes publicados y las comparaciones de pruebas resumen estas percepciones y mediciones por parte de usuarios y testers. No incluyen mecanismos detallados o atribuciones definitivas para el cambio en rendimiento. Las declaraciones aquí descritas derivan de informes de usuarios y comparaciones de testers.
El término «valor de jugo» se utiliza como una forma abreviada para la cantidad de esfuerzo computacional que el modelo gasta pensando antes de responder. No es un término oficial y no ha sido definido formalmente. Los evaluadores y observadores han usado esta abreviatura al discutir el rendimiento de GPT-6 Astra en comparaciones entre el modelo del día de lanzamiento y las versiones posteriores. Estos informes incluyen la sospecha específica de que OpenAI redujo el valor de jugo del modelo después de las demostraciones de lanzamiento, expresada por algunos como una reducción silenciosa de ese esfuerzo computacional.
Pranjal Paliwal, quien revisó el código de GPT-6 Astra, comentó que el estado actual del modelo indica “No tenemos AGI. Tenemos una regresión.” AGI significa inteligencia general artificial, que busca realizar cualquier tarea intelectual que un humano pueda hacer. El lanzamiento de GPT-6 Astra presentó al presidente de OpenAI haciendo referencia al término AGI, destacando las aspiraciones para el modelo. Estas declaraciones capturan algunas opiniones de expertos sobre las capacidades actuales de Astra en comparación con sus promesas iniciales en el lanzamiento.
El artículo cubrió informes que los usuarios y evaluadores perciben que GPT-6 Astra ha disminuido en rendimiento desde su lanzamiento, describiendo al modelo como significativamente más tonto en comparaciones directas.
Los observadores informaron tiempos de respuesta más rápidos en la versión posterior, pero evaluaron la calidad de la salida como peor y levantaron la sospecha de que el “valor de jugo” del modelo—una abreviatura para el esfuerzo computacional que el modelo gasta pensando antes de responder—había sido reducido; Salio y Md Ismail Sojal probaron mensajes idénticos en el día del lanzamiento y versiones posteriores y registraron peores resultados en la versión posterior.
La cobertura también incluyó la conclusión de revisión de código de Pranjal Paliwal de que el lanzamiento constituye una regresión en lugar de AGI, y notó que el presidente de OpenAI utilizó el término AGI en el lanzamiento de Astra.


